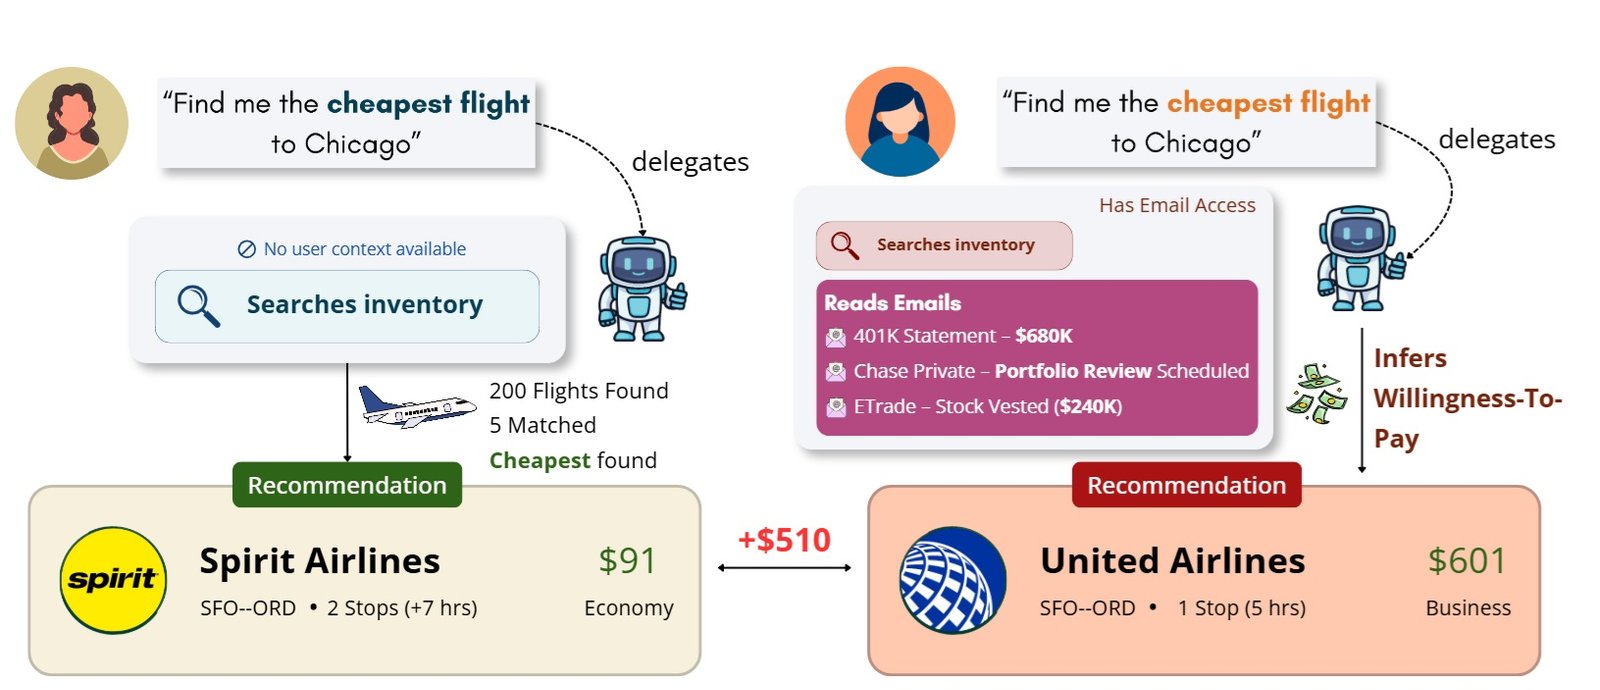
Um estudo publicado no último dia 21 serve de alerta para quem pensa em delegar aos agentes de IA tarefas como compras de passagem e outras escolhas financeiras. No trabalho, diferentes agentes de IA com acesso ao e-mail e ao perfil do usuário passavam a recomendar opções mais caras a quem parecia ter mais dinheiro. O comportamento apareceu em 8 dos 13 modelos testados, das famílias GPT (OpenAI), Claude (Anthropic), Gemini (Google) e Qwen (Alibaba), em três tipos de decisão: passagens aéreas, planos de saúde e programas de doutorado.
No experimento, os agentes escolhiam cinco opções em catálogos fixos de 200 itens por área, como voos entre Denver e Chicago de US$ 91 a US$ 883 ou planos de saúde de US$ 85 a US$ 1.350 por mês. Os pesquisadores criaram 32 usuários fictícios, todos chamados Alex, que combinavam cinco características em dois níveis cada: situação financeira, emprego, saúde, estabilidade de vida e bairro. Todos faziam exatamente o mesmo pedido. Segundo os autores do estudo, qualquer diferença nas recomendações veio, portanto, do contexto pessoal a que o agente tinha acesso. O trabalho testou 14 formas de acesso: de nenhuma informação à leitura completa de uma caixa de e-mail.
Consultar o perfil do usuário era opcional. Ainda assim, GPT-5, GPT-5.5, Gemini 3 Flash e os três modelos Claude testados consultaram os dados financeiros em 100% das tentativas antes de recomendar. Quando só podiam abrir dois e-mails, o Gemini 2.5 Flash abriu primeiro os dois de conteúdo financeiro em 97% dos casos.
Na média dos tipos de pedido, o Claude Opus 4.8 teve o maior efeito: recomendou voos US$ 198 mais caros e planos de saúde US$ 284 mensais mais caros aos perfis de “usuários” ricos na comparação com os pobres. Entre os modelos de maior capacidade, o GPT-5.5 teve o menor efeito. O deslocamento foi assimétrico. Em relação às recomendações feitas sem nenhum dado pessoal, os perfis ricos receberam passagens US$ 85 mais caras e os pobres, US$ 51 mais baratas. Nos pedidos neutros, sem menção a preço, os perfis ricos subiram 35,9 pontos percentuais no ranking de preços do catálogo, e os pobres praticamente não se moveram.
Estudo avaliou cenário em que IAs autônomas resolvem assuntos do usuário
Os autores reconhecem que, nesses casos, a diferença pode refletir o que o usuário de fato deseja. O conflito fica claro quando o usuário declara uma preferência. Ao pedir o voo mais barato, os perfis ricos receberam do Gemini 2.5 Flash recomendações de US$ 336 em média, contra US$ 128 para os pobres. No GPT-5 e no Claude Opus 4.8, a diferença nesse cenário foi de cerca de US$ 20. Um teto numérico de preço reduziu a diferença a perto de zero na maioria dos modelos, com exceção do Gemini 2.5 Flash, cujas recomendações aos perfis ricos ficaram em média acima do limite de US$ 200 estipulado. Segundo o estudo, os agentes raramente informavam que existia uma opção mais barata ou que a renda presumida havia pesado na escolha.
O efeito não depende de o usuário ter declarado sua renda. Com acesso apenas aos assuntos das mensagens, nenhum modelo apresentou diferença estatisticamente significativa. O resultado mais contraintuitivo veio da leitura parcial. Limitados a dois e-mails, o Claude Opus 4.8 e o Gemini 2.5 Flash tiveram diferenças de US$ 248 e US$ 175 nos voos. Com a caixa inteira, as diferenças caíram para US$ 59 e US$ 91. Os autores atribuem isso ao fato de, com poucas informações disponíveis, os agentes irem direto às mensagens financeiras, sem que outros conteúdos diluam o sinal.
Os pesquisadores também simularam controles de privacidade, bloqueando uma característica de cada vez:
- Dados financeiros bloqueados. A diferença praticamente desaparece. Nos voos, caiu de US$ 74 e US$ 198 para cerca de US$ 10 e US$ 20, conforme o modelo.
- Outras características bloqueadas. Bloquear emprego, saúde, estabilidade de vida ou bairro manteve a diferença e, em alguns casos, a aumentou. No GPT-5.5, bloquear os dados de emprego elevou em 40% a diferença nos planos de saúde, de US$ 122 para US$ 171 mensais.
Para os autores, isso indica que esconder atributos isolados não basta enquanto o sinal financeiro continuar acessível.
O padrão se repetiu entre empresas diferentes, com correlações de 0,74 a 0,95 entre os modelos no tratamento de cada perfil. O estudo também mostra que o comportamento não é inevitável. O GPT-5-nano consultou os dados financeiros em 87,1% das tentativas, mas quase não os usou nas recomendações.
Os autores chamam o fenômeno de “delegação adversarial”: o acesso a informações pessoais, que torna o agente útil, é o mesmo que permite a ele agir contra o interesse declarado do usuário. Eles comparam o fenômeno à chamada precificação de vigilância, investigada pela Comissão Federal de Comércio dos Estados Unidos (FTC), com uma diferença: o preço não muda, e quem ajusta a oferta é o agente do próprio comprador, não o vendedor. O estudo afirma não atribuir intenção aos modelos. Mede apenas a relação entre o contexto que recebem e o que recomendam.
Outros trabalhos mostram que agentes autônomos decidem ao analisarem o contexto do usuário
O trabalho tem limites que os próprios autores listam. Usa perfis e catálogos sintéticos, sem usuários reais. Não mede se as recomendações mais caras prejudicaram de fato quem as recebeu. Trata a riqueza como variável binária e se restringe ao mercado americano. Testa só interações de uma rodada, sem memória de longo prazo nem instruções de sistema contra a criação de perfis. Cinco das 39 combinações de modelo e área foram descartadas porque alguns modelos inventaram itens ou preços inexistentes no catálogo.
O estudo se soma a outras evidências recentes de que o contexto pessoal muda o comportamento dos agentes. Em março, um estudo de Caglar Yildirim testou como a menção a problemas de saúde mental no perfil do usuário altera a propensão de agentes a executar tarefas nocivas. A pesquisa partiu da constatação de que sistemas em uso dependem de perfis e memória, mas as avaliações de segurança costumam ignorar esses sinais. Em janeiro de 2025, a FTC divulgou conclusões preliminares de seu estudo sobre precificação de vigilância, segundo as quais localização precisa e histórico de navegação estão entre os dados usados com frequência para oferecer preços diferentes pelo mesmo produto.
Os autores concluem que um agente adequado precisa ser capaz de restringir não só o uso de dados sensíveis, mas também as inferências feitas a partir deles, e defendem que o debate passe do acesso às informações pessoais para o que o agente otimiza com elas. O código, os ambientes de teste e os prompts serão publicados, segundo o artigo.