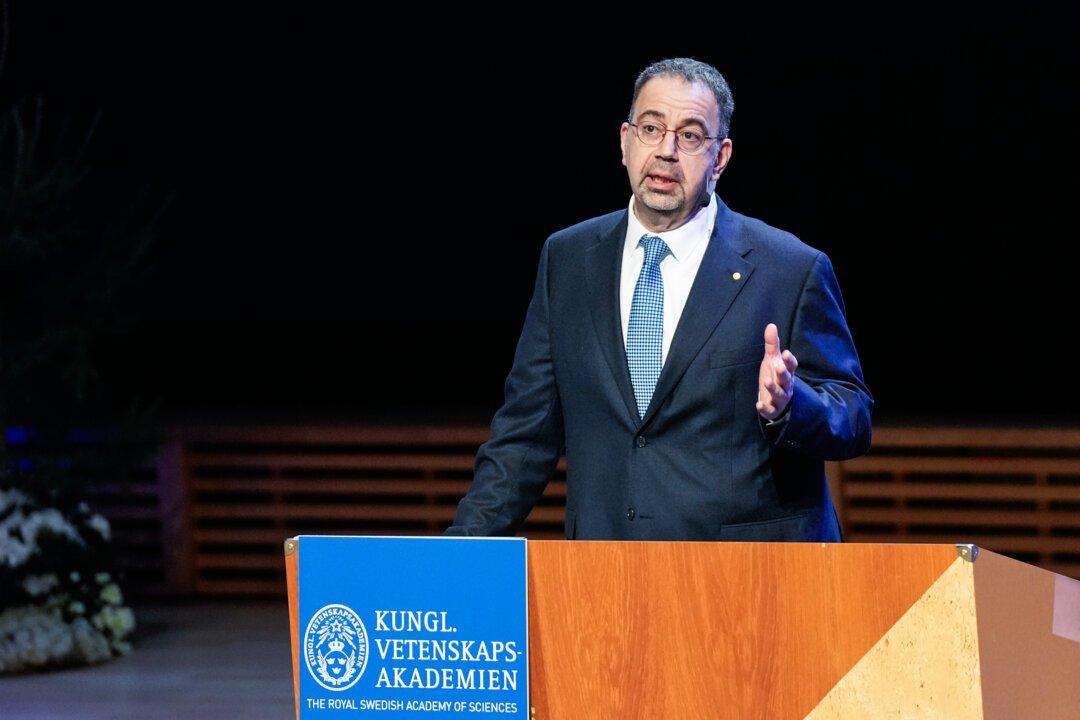
O economista Daron Acemoglu, professor do MIT e Nobel de Economia de 2024, assina dois trabalhos recentes que chegam, por caminhos diferentes, à mesma desconfiança: a inteligência artificial pode empobrecer o conhecimento coletivo quando aprende com o que ela própria ajudou a produzir ou quando passa a substituir o esforço humano que alimenta esse conhecimento.
Os textos são working papers do NBER, o Escritório Nacional de Pesquisa Econômica dos Estados Unidos: How AI Aggregation Affects Knowledge, de abril de 2026, escrito com Tianyi Lin, Asuman Ozdaglar e James Siderius, e AI, Human Cognition and Knowledge Collapse, com Dingwen Kong e Ozdaglar, em versão de 5 de maio de 2026.
A IA aprende com o que ajudou a criar
No primeiro trabalho, Daron Acemoglu e seus colegas imaginam uma sociedade em que as pessoas formam opinião ouvindo vizinhos, amigos e veículos de imprensa. Em seguida, introduzem um “agregador” de IA, parecido com um grande modelo de linguagem, treinado com as crenças da população e que devolve à rede um sinal sintetizado. Como esse sinal volta a influenciar as crenças, surge um ciclo de retroalimentação: a IA passa a ler opiniões que ela mesma ajudou a moldar.
O resultado central é um limiar de velocidade. Quando o agregador se atualiza rápido demais, acompanhando as crenças do momento, não existe conjunto de pesos de treinamento que melhore o aprendizado de forma robusta em ambientes plausíveis. Se a atualização é suficientemente lenta, existe. Os autores comparam o fenômeno ao chamado colapso de modelos (model collapse): mesmo com muitos dados, a qualidade piora quando eles refletem cada vez mais conteúdo gerado por modelos, e não sinais independentes.
O estudo também mostra quem ganha peso na conversa. Em redes segregadas, nas quais cada grupo fala sobretudo consigo mesmo, treinar a IA com mais peso para a maioria faz o aprendizado piorar à medida que a segregação aumenta. Dar mais peso à minoria ajuda apenas em níveis intermediários de segregação; com pouca ou muita, o remédio corrige demais ou deixa de funcionar. Corrigir a sub-representação nos dados, portanto, não é só questão de justiça: é também requisito de robustez.
A saída apontada está na arquitetura. Agregadores locais e específicos por tema, como jornais regionais ou sites comunitários, melhoram o aprendizado em todos os cenários do modelo, porque mantêm os ciclos de retroalimentação separados. Já trocar esses intermediários por um único agregador global piora o resultado em pelo menos um tema.
Quando a IA responde tão bem que ninguém precisa aprender
O segundo trabalho troca o foco da informação pelo incentivo humano. Para decidir bem, uma pessoa precisa de conhecimento geral, que pertence à comunidade, e de conhecimento específico do seu contexto. O esforço de aprender produz os dois ao mesmo tempo, mas o retorno privado vem quase todo do segundo. O conhecimento geral que cada um gera acaba beneficiando os outros: é uma externalidade.
A IA agêntica, capaz de dar recomendações sob medida, entra nesse quadro como substituta do esforço humano, enquanto o conhecimento geral é o que torna o esforço mais valioso. No curto prazo, o efeito é positivo: decisões melhores. No longo, pode ser o oposto. Se as pessoas se esforçam menos, o estoque de conhecimento geral deixa de ser renovado. O modelo mostra que, quando o esforço é suficientemente elástico e a IA é precisa demais, a sociedade pode cair em um estado de colapso do conhecimento, no qual o conhecimento geral desaparece mesmo com conselhos personalizados excelentes.
Daí uma conclusão contraintuitiva: o bem-estar não cresce sempre com a precisão da IA. Existe um nível ótimo, intermediário, e acima dele mais precisão reduz o bem-estar. Os autores analisam uma política que “embaralha” de propósito a informação da IA: uma fase inicial de restrições severas para reconstruir o estoque de conhecimento, seguida de um teto permanente de precisão.
Ampliar a capacidade da comunidade de compartilhar conhecimento produzido por humanos, ao contrário, aumenta o bem-estar e reduz o risco de colapso. Dados sintéticos, gerados pela própria IA, só criam um piso: evitam o zero, mas não substituem o esforço humano.
O artigo cita evidências que combinam com a hipótese: menos atividade no Stack Overflow depois da adoção de IA generativa, menos leitura e produção na Wikipédia em áreas em que o ChatGPT a substitui bem, e um estudo com 26.811 estudantes chineses do ensino básico, cujas notas em tarefas de casa subiram com o uso de IA, enquanto as de provas sem consulta ficaram bem piores.
O que há de comum nos dois estudos de Daron Acemoglu
| Aspecto | Agregação por IA | Cognição e colapso do conhecimento |
|---|---|---|
| Pergunta | A IA melhora o aprendizado coletivo quando treina com crenças que ela mesma moldou? | A IA que dá respostas sob medida corrói o esforço que sustenta o conhecimento comum? |
| Mecanismo do risco | Ciclo entre crenças da população e dados de treinamento | Substituição do esforço humano de aprender e produzir conhecimento |
| Fator crítico | Velocidade de atualização do agregador | Precisão das recomendações da IA |
| O que protege | Agregadores locais e por tema; atualização mais lenta | Mais compartilhamento de conhecimento humano; teto de precisão |
Três ideias se repetem. A primeira é que a IA não é um espelho neutro. Nos dois modelos, ela altera o material do qual vai aprender depois, seja porque as pessoas passam a repetir o que a IA sintetizou, seja porque deixam de produzir o conhecimento original que a alimentaria.
A segunda é a perda de diversidade independente. O primeiro estudo fala em redução da diversidade efetiva de informação; o segundo, em esvaziamento do estoque de conhecimento geral. Nos dois casos, mais dados não resolvem se eles deixam de ser independentes.
A terceira é que a pergunta de projeto não é se a IA agrega informação, mas como. O primeiro trabalho resume que o decisivo é a amplitude das fontes, a rapidez das atualizações e a forma como elas voltam à população. O segundo, quanto a IA pode saber sobre cada indivíduo sem desligar o motor do aprendizado humano. Daron Acemoglu e os coautores não concluem que a IA seja prejudicial por natureza: níveis moderados ajudam, e arquiteturas modulares melhoram o aprendizado.
Limites e perguntas em aberto
Os modelos de Daron Acemoglu e dos coautores são estilizados. O primeiro trabalha com dois grupos e um único número como “crença”; o segundo, com funções de produção simplificadas e uma população que se renova a cada período. Nenhum foi testado com dados reais, e os próprios autores tratam a verificação empírica como tarefa futura. Resultados como o limiar de elasticidade do esforço dependem de hipóteses sobre incentivos que ainda precisam ser medidas.
Há ainda uma tensão aparente, e aqui a leitura é minha, não dos autores. O segundo estudo afirma que ampliar a agregação do conhecimento sempre aumenta o bem-estar; o primeiro mostra que a agregação global com atualização rápida torna o aprendizado frágil. A diferença está no que é agregado: no segundo, conhecimento produzido por humanos e compartilhado; no primeiro, um sistema que treina com crenças que ele próprio ajudou a moldar.
O segundo estudo acrescenta que o benefício da agregação cresce apenas com o logaritmo da escala, o que tende a ser pouco diante do efeito de uma IA agêntica cada vez mais precisa.
Por que isso interessa a quem trabalha com informação
Para jornalistas, comunicadores e gestores de conhecimento, a mensagem prática dos estudos de Daron Acemoglu é bastante útil. Os veículos locais e as comunidades especializadas, tratados no primeiro estudo como agregadores locais, funcionam como amortecedores: mantêm fontes próximas do fato e separadas dos ciclos globais. É o tipo de função que a disputa pela fidelidade do leitor coloca em jogo. A discussão também dialoga com a pergunta de como dados, algoritmos e poder se entrelaçam e com a de quem paga a conta das transformações tecnológicas.
Sobre Daron Acemoglu
Daron Acemoglu, professor do MIT, dividiu o Nobel de Economia de 2024 com Simon Johnson e James A. Robinson, por estudos sobre como as instituições se formam e afetam a prosperidade. Em 8 de dezembro de 2024, ele proferiu a palestra do Nobel, “Institutions, Technology and Prosperity”, no Aula Magna da Universidade de Estocolmo. Os dois trabalhos se somam a uma linha de pesquisa sobre tecnologia e trabalho que ele desenvolve há anos com Pascual Restrepo, citada nas referências do segundo artigo.